

- 1 つのモデルで生成と編集: 同じ重みがテキストから画像へのプロンプトと編集指示の両方に対応するため、ワークフローでチェックポイントを切り替える必要がありません
- ネイティブ 2K 出力: 小さい結果をアップスケーリングするのではなく、最大 2048x2048 で直接生成できます
- プロフェッショナルなタイポグラフィ: 高密度の小さなテキストや複雑なレイアウトも維持されるため、インフォグラフィック、スライド、UI モックアップ、ポスター、パッケージデザインに適しています
- アルファチャンネルのサポート: VAE が 4 つのチャンネルを持つため、透明な背景の画像を直接生成および編集でき、後から切り抜く必要がありません
- マルチ画像編集: 参照画像はスロットの順序でテキストエンコーダーに結合されます。Text Encode Qwen Image 2.1 ノードは最大 16 スロット(
image_1からimage_16)を受け付け、このページの 2 つの編集テンプレートは最初の 10 個(image_1からimage_10)を接続しています。image_1は編集対象の画像で、残りは内容を補うためのものです。プロンプトはインデックスでそれらを参照します。たとえばimage_1は<image1>と記述します - ローカル編集: 変更したいオブジェクトや領域を記述すると、画像の残りの部分は保持されます
Qwen-Image-2.1 ワークフロー
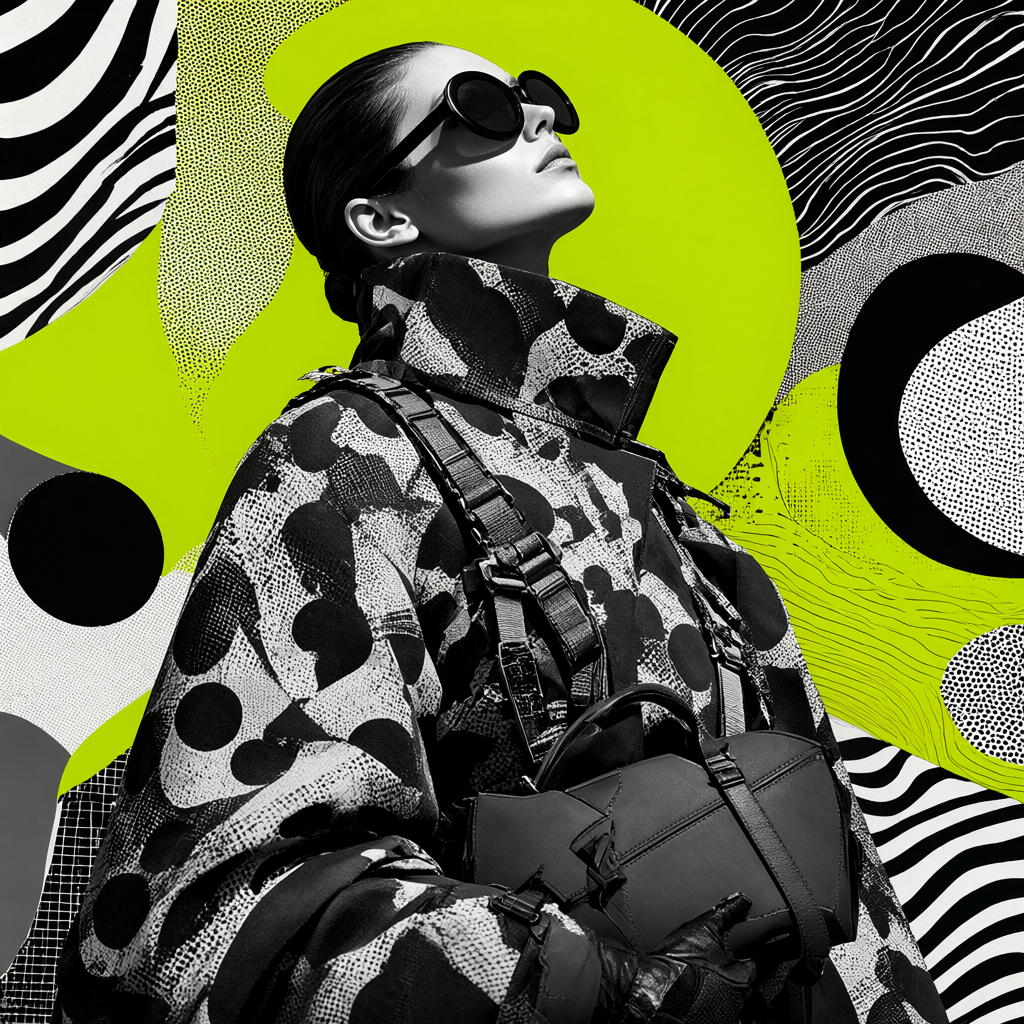
Qwen Image 2.1 テキストから画像へ
選択したアスペクト比とメガピクセル数に合わせて、テキストプロンプトから画像を生成します。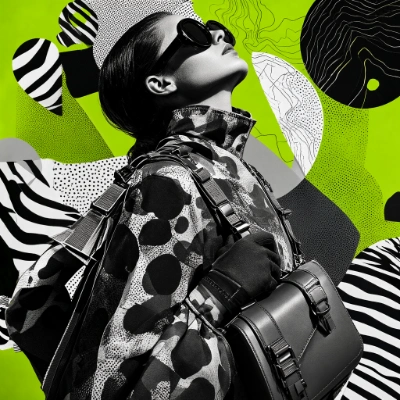
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen-Image-2.1」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
Qwen Image 2.1 画像編集
指示に従って画像を編集します。編集にソース画像にないコンテンツが必要な場合は、参照画像を追加してください。たとえば、2 枚目の写真の衣服を 1 枚目の人物に着せる場合などです。
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen-Image-2.1」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
LoadImage ノードにアップロードしてください:
portrait_model_denim.png
LoadImage ノード 470 · portrait_model_denim.pngclothing_light_blue_denim_shirt.png
LoadImage ノード 475 · clothing_light_blue_denim_shirt.png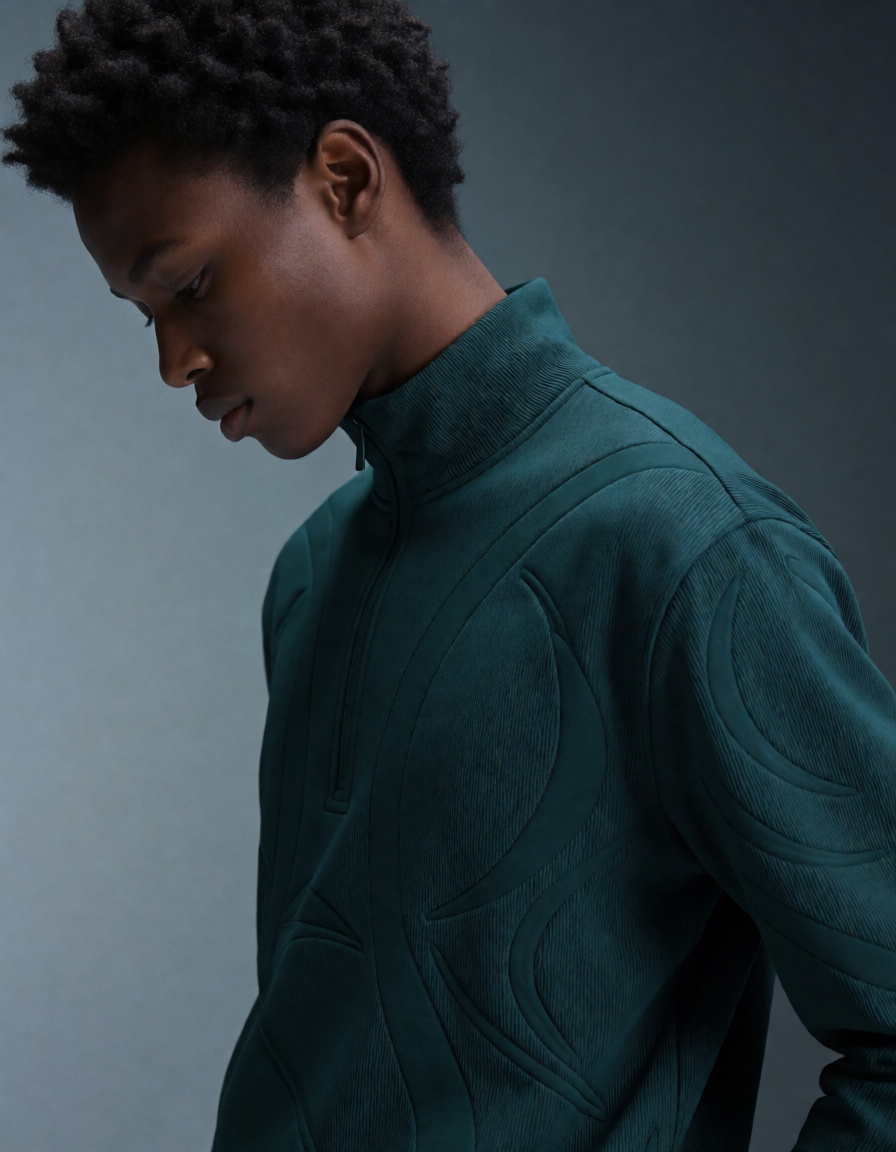
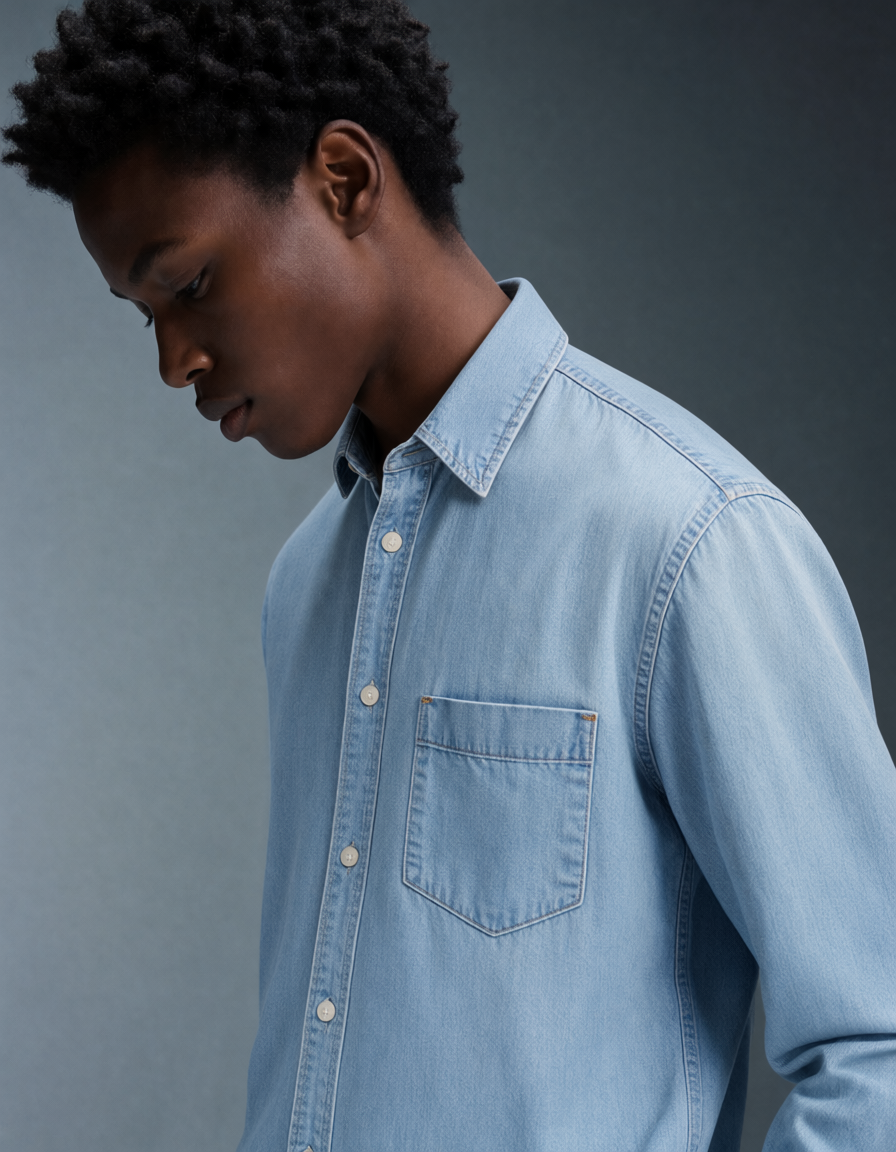
背景の削除: Qwen Image 2.1
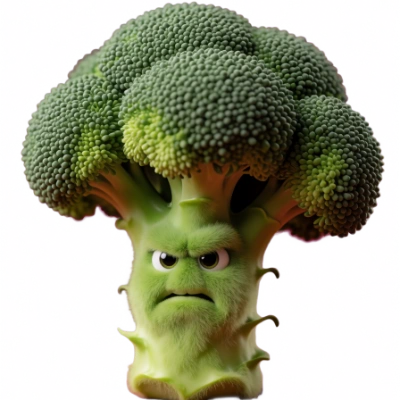
編集指示で写真の背景を削除します。このワークフローは画像編集のサブグラフを再利用し、プロンプトはRemove the background, and output a PNG image です。結果は元画像と比較できます。
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen-Image-2.1」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
LoadImage ノードにアップロードしてください:
angry_broccoli.png
LoadImage ノード 470 · angry_broccoli.pngモデルのダウンロード先
3 つのワークフローは diffusion モデル、VAE、ベースのテキストエンコーダーを共有します。Text to image と Image edit のテンプレートはそれぞれプロンプト強化用のテキストエンコーダーを追加で読み込みます。Text to image はqwen3.5_9b_qwen_image_2.1_pe_t2i、Image edit は qwen3.5_9b_qwen_image_2.1_pe_i2i です。
text_encoders
- qwen3vl_8b_int8_convrot.safetensors(テンプレートが読み込むデフォルト、メモリ使用量は少なめ)
- qwen3vl_8b_bf16.safetensors(フル精度、より多くのメモリが必要)
- qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors(Text to image テンプレートのプロンプト強化)
- qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors(Image edit テンプレートのプロンプト強化)
- qwen_image_2.1_int8_convrot.safetensors(テンプレートが読み込むデフォルト、メモリ使用量は少なめ)
- qwen_image_2.1_bf16.safetensors(フル精度、より多くのメモリが必要)
ワークフロー設定
サンプラー設定
3 つのワークフローはいずれもsteps 25、cfg 1、euler サンプラー、simple スケジューラーでサンプリングします。
cfg が 1 のとき ComfyUI はネガティブ条件の計算をスキップするため、これらのワークフローではネガティブプロンプトが効果を持ちません。テンプレートは Qwen-Image-2.1 が公開されている経路である cfg 1 を維持しており、ネガティブプロンプトを効かせたい場合にのみ上げてください。cfg 2 では、小さな文字や数字を含む密なプロンプトへの追従性が上がりますが、その代わりエッジが過剰に強調されます。それより上げると露出が明るすぎたり暗すぎたりする方向に振れ、cfg 5 では品質が大きく低下し、cfg 0.5 では画像が壊れます。値は一度に 1 つだけ変え、固定シードで比較してください。
steps は 2 つ目の調整項目です。Qwen-Image-2.1 の公開パイプラインは euler サンプラーで約 40 から 50 ステップを使用しており、テンプレートはより低い 25 から始まります。単純な局所編集は 4 から 8 ステップでも成立するため、服の色を変えるといった指示はデフォルトより数倍速く生成できます。一方、画面全体を書き換える編集は一貫性を失い、25 ステップが必要です。手や指のような収束しにくい細部は 30 ステップ程度で落ち着き、25 から 40 ステップに上げると細部のざらつきが減ります。steps は、特定の箇所がどうしても収束しないときだけ調整してください。
解像度
Text to image:Resolution Selector ノードがアスペクト比とメガピクセルの目標値を設定します。1.0 MP はおよそ 1024x1024 です。Qwen-Image-2.1 は 2K をネイティブに生成するため、2048x2048 の正方形出力を得るには目標値を約 4.0 MP に設定してください。 Image edit:キャンバスは Image Edit サブグラフノードのresolution コントロールで決まります(範囲 0 から 4096、ステップ 32)。ノード自体のデフォルトは 1024 で、テンプレートは 0 で配布されています。テンプレートのデフォルトである custom_size オフの場合、編集は最初の参照画像 image_1 のサイズで生成されます:
resolutionが0の場合、各参照画像は自身のピクセルサイズのまま(32 の倍数に丸めて)保持されるため、3000x4000 の写真は 3008x4000 のキャンバスになりますresolutionが0より大きい場合、image_1のアスペクト比をresolutionxresolutionピクセルの予算に合わせてスケーリングします。これは幅や高さではなく総ピクセル数であり、32 の倍数に丸められるため、同じ写真でresolution1024は約 896x1184 になります
custom_size をオンにすると、代わりに Resolution Selector からキャンバスを取得します。このときはリサイズ後の image_1 のサイズに近い値にしてください。そうしないと編集がずれる可能性があります。
コストを決めるのはキャンバスサイズです。3000x4000 の参照画像は resolution が 0 のとき 3008x4000(約 12 MP)でサンプリングされ、同じ編集を resolution 1024 にすると約 896x1184(約 1 MP)になります。RTX 5090 ではおよそ 6 s/it と約 0.3 s/it の差になります。resolution を下げると生成結果が小さくなることで速くなり、細部が増えるわけではありません。編集が遅いと感じたら、他の設定を触る前に resolution と参照画像のピクセルサイズを確認してください。大きな参照画像を複数使うとさらに遅くなり、そのコストには下記の KV キャッシュ設定が影響します。また、モデルの学習済み 2K を大きく超える目標値(4K など)はプロンプト追従性が落ちます。
画像編集のためのプロンプト
参照画像はスロット順にテキストエンコーダーへ連結され、プロンプトは各画像をインデックスで指定します:image_1 を供給する LoadImage ノード(ノード 470:ノードを右クリックし、マスクエディタで開く を選択)で Paint Pen を使い、領域を塗って保存します。Paint Pen はマスクではなく画像の RGB レイヤーに描画するため、保存するとマーク付きの画像がノードに書き戻され、マークはこの編集が読み込む参照画像の一部になります。プロンプトでマークの色を指定すると、その指示をその領域に向けられます(例:「赤い領域のジャケットを変更する」)。マークは変更したい領域内にとどめてください。マークの色が結果に現れる場合は、希望する色もプロンプトに書いてください。
KV キャッシュ
編集ワークフローには Qwen Image 2.1 Cache ノードが含まれており、サンプリングのステップ間でキャッシュされたテキストと参照プレフィックスを保持します。テンプレートのデフォルト設定はほとんどの環境でそのまま使えます。 このノードは実験的な機能で、2 つのコントロールがあります:プロンプト強化
Text to image と Image edit のテンプレートには、任意のプロンプト強化ステップが含まれます。専用のテキストエンコーダーがサンプリング前にプロンプトを書き換え、短いリクエストをより詳細な記述に展開します。 どちらのテンプレートも、Qwen Image 2.1 サブグラフノードに次のコントロールを公開しています:refine_prompt:両方のテンプレートでデフォルトはオフです。オンにすると、画像モデルは入力したプロンプトではなく書き換え後のプロンプトでサンプリングしますPE_model:書き換えを行うテキストエンコーダーです。Text to image はqwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors、Image edit はqwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensorsを使用しますthinking_mode:両方のテンプレートでデフォルトはオフです。refine_promptと一緒にオンにすると、書き換えモデルが出力前に推論できるようになります
refine_prompt がオンのときだけ評価されるため、強化用テキストエンコーダーは両方のテンプレートで任意です。使用するには refine_prompt をオンにしてください。背景除去テンプレートにはこのステップはありません。